Memory Workload Analysis

AI 추론 워크로드에서
필요한 메모리를 역산합니다

모델과 컨텍스트 길이와 동시 요청 수를 입력하면 필요한 메모리 용량과 가속기 대수가 산출됩니다. 숫자는 전부 결정론적 계산으로 구하고, LLM 은 그 결과를 문장으로 옮기는 데에만 사용합니다. 계산이 맞는지는 같은 구조를 데스크탑 한 대에서 실행하여 확인합니다.

계측 결과 보기기반 구현 4건 내려받기

표와 도표마다 측정값인지 계산값인지 표시하였습니다.

아래는 상세 내용입니다.

Part 1

Memory Workload Simulator

고객의 추론 워크로드를 입력하면 필요한 메모리 용량과 대역폭과 계층 배치와 가속기 대수를 역산하는 도구입니다. 그리고 이 도구를 데스크탑 한 대에서 실행하면서 메모리가 어느 지점부터 부족해지는지 함께 기록합니다.

설계 원칙 세 가지

숫자는 계산기가 산출합니다
용량과 대역폭과 대수는 전부 결정론적 코드가 계산합니다. LLM 은 그 결과를 고객의 언어로 옮기기만 합니다. 순서를 바꾸면 LLM 이 생성한 숫자가 그대로 제안이 됩니다.
출처가 없는 주장은 통과시키지 않습니다
고객의 발화에 들어가는 근거는 공개 출처가 첨부된 것만 사용합니다. 마지막 검증 단계가 출처 없는 문장에 표시를 부여합니다.
제안이 실패하는 이유를 함께 산출합니다
아키타입마다 경쟁사가 우위를 점하는 근거와 고객이 제기할 반론을 함께 출력합니다. 이 항목이 빠지면 한쪽 편의 자료가 됩니다.

한 사이클

2단계와 3단계의 순서가 이 도구의 핵심입니다. 숫자를 먼저 확정하고 LLM 은 그다음에만 개입합니다.

단계수행하는 일담당
입력고객 아키타입을 선택하고 워크로드를 서술합니다. 서술 항목은 모델, 컨텍스트, 동시성, 서비스 수준 목표, 예산 제약입니다.사람
1그 고객의 공개 사양과 실적과 시장 자료를 검색하여 근거를 확보합니다.RAG
2필요한 메모리 용량과 대역폭과 계층 배치와 가속기 대수를 역산합니다.결정론적 계산기
3산출된 숫자를 그 아키타입이 실제로 사용할 법한 표현으로 옮깁니다.LLM
4그 고객이 제안에 대해 제기할 반론을 생성합니다.LLM 과 아키타입 카드
5근거가 없는 주장에 표시를 부여합니다.검증 에이전트
출력문제점 목록과 제품 제안 후보와 예상 반론과 제안이 실패하는 이유를 산출합니다.없음

이 사이클에 포함되지 않은 기능은 구현하지 않습니다.

구성 요소

01

정량 엔진

완료

워크로드를 입력하면 메모리 사양이 산출됩니다. LLM 은 여기에 관여하지 않습니다.

토큰 하나당 KV cache 크기는 어텐션 방식마다 계산식이 다릅니다. MHA 와 GQA 와 MQA 는 K 와 V 를 각각 저장하지만, MLA 는 저차원 잠재 표현 하나만 저장하므로 계산식 자체가 달라집니다. 이 차이를 모델 프로파일에 반영해 두고 시작합니다.

모델 프로파일과 가속기 사양과 메모리 계층표 세 가지를 놓고 워크로드를 입력하면, 가중치와 KV cache 용량, 필요한 가속기 대수, 그 가운데 KV cache 때문에 증가한 대수, roofline 상의 병목 종류, 초과분을 어느 계층에 배치할 수 있는지가 산출됩니다.

값보다 중요한 것은 병목의 종류가 고객마다 다르다는 사실입니다. 같은 엔진에 MLA 계열의 대형 모델을 입력하면 KV cache 와 가중치의 비율이 0.86배로 역전되어 병목이 KV cache 가 아니라 가중치가 됩니다. 그 고객에게 계층 분리를 제안하면 초점을 잘못 읽은 것이 됩니다.
구현 범위
  • 모델 프로파일: MHA 와 GQA 와 MQA 와 MLA 별 KV 계산식
  • 가속기 프로파일: 용량, 대역폭, 최대 연산 성능
  • 메모리 계층 7단: 대역폭, 지연, 용량 상한
  • 대수 산정: 필요 대수와 KV cache 때문에 증가한 대수를 분리
  • Roofline 임계점과 노드당 decode 연산 강도
  • 초과분 계층 배치 판정: 서비스 수준 목표와 용량 두 축을 동시에 확인
  • 계산 결과를 제품 제안 후보로 매핑
가속기 사양에는 출처와 신뢰도를 1차와 2차와 상충으로 구분하여 함께 기재합니다. 상충하는 값은 보수적인 쪽을 채택합니다.
02

계측 하네스

완료

스택이 동작하는 동안 자기 자신의 메모리를 측정합니다.

사이클마다 페이지 캐시 점유량과 major page fault 와 프로세스 상주 메모리와 커널의 메모리 압력 지표를 기록합니다. 계산기가 산출한 숫자를 같은 기계에서 검증하는 것이 목적입니다.

메모리 매핑으로 색인을 열면 프로세스의 메모리 사용량은 거의 증가하지 않습니다. 그래서 메모리를 사용하지 않는 것처럼 보이지만 페이지 캐시를 통해 DRAM 을 실제로 점유하고 있습니다. E3 가 측정하는 대상이 정확히 이 지점입니다.

구현 범위
  • 페이지 캐시와 사용 가능 메모리를 사이클별로 기록
  • major page fault 증분: 축출이 시작된 시점의 신호
  • 커널 메모리 압력 지표 수집
  • 지연 분포를 50분위와 99분위로 분리하여 기록
03

고객 아키타입 5종

완료

페르소나를 개인이 아니라 의사결정 구조로 정의합니다.

하이퍼스케일러 자체 실리콘 조직, 범용 가속기 공급사, 신흥 클라우드 사업자, 스마트폰 제조사, 엣지 및 로보틱스 다섯 종입니다. 각각에 누가 결재하는지, 무엇으로 평가받는지, 무엇을 양보할 수 없는지, 의사결정 주기가 어떠한지를 기술하였습니다.

성격과 말투는 기술하지 않았습니다. 구매 조직의 구조가 문제점의 성격을 결정하기 때문입니다. 각 아키타입에는 그 고객이 제기할 반론과 공급 측이 그 고객을 놓치는 이유가 함께 들어갑니다.

출처를 확인하지 못한 주장 13건은 문제점 목록에서 분리하여 별도로 관리하고 도구가 산출하는 결과에는 포함하지 않습니다. 정량 근거를 확보하지 못한 아키타입에는 그 사실을 표시해 두고 수치를 제시하지 않습니다. 엣지 및 로보틱스가 현재 그 상태입니다.

카드에 들어가는 항목
  • 의사결정 구조: 결재자, 평가 지표, 양보 불가 항목, 주기
  • 확인된 공개 사양과 그 출처
  • 문제점 목록: 근거 첨부가 필수입니다
  • 공급사에 요구하는 것
  • 경쟁에서 밀리는 이유
  • 고객이 제기할 반론
출처가 없는 항목은 카드에 싣지 않습니다.

계산 예시

비용을 최우선으로 하는 추론 서비스 한 곳을 가정하고 엔진에 입력한 결과입니다. 아래 값은 전부 같은 명령으로 재현됩니다.

항목해석
입력Llama 3.1 70B · 32K 컨텍스트 · 128 동시 · 가중치 4-bit · KV FP8 · 플랫폼 H100 80GB고객이 실제로 실행하는 구성입니다. 70B 는 계산 기준 모델이며 서빙 대상이 아닙니다
KV / token163,840 B2(K,V) × 80층 × KV head 8 × head dim 128 × 1 B
가중치32.6 GB4-bit 기준입니다
KV cache625.0 GB128 요청 × 32,000 토큰 = 4,096,000 슬롯
KV / 가중치19.2배모델 크기로 메모리를 산정하는 통상적인 방식이 성립하지 않는 구간입니다
KV·가중치 교차점213,623 슬롯현재 4,096,000 슬롯이므로 교차 지점을 한참 지났습니다
필요 가속기19장런타임 부가 점유 20% 를 포함합니다
그중 KV 보관용18장 (95%)연산이 필요해서 구입하는 것이 아닙니다
Roofline 임계점295 FLOP/byte이보다 연산 강도가 낮으면 메모리 대역폭에 의해 제한됩니다
노드당 decode 강도6.7대역폭에 의해 제한됩니다. 배치를 키우면 그 전에 KV cache 가 먼저 초과합니다
초과분 709 GB 배치LPDDR 13.1 ms · DDR5 87.4 ms · CXL 145.7 ms · NVMe 749.2 ms요청 한 건분 KV 4.88 GB 를 전송하는 기준이며, 첫 토큰 목표 500 ms 에서 NVMe 만 탈락합니다

이 표에 고대역폭 플래시 계층은 넣지 않았습니다. 양산 전 기술이므로 공개된 값이 목표 사양이며 측정된 값이 아닙니다. 엔진에는 계층으로 포함되어 있지만 출력에 그 단서를 함께 표시합니다.

계측 실험 3종

가속기가 필요하지 않은 실험부터 순서를 정하였습니다.

변화시키는 변수산출된 결과구분
E3 · 메모리 경합동거 프로세스가 점유하는 메모리를 증가시키며 벡터 색인의 검색 지연을 측정합니다메모리가 6.7 GB 남아 있는 상태에서 99분위 지연이 4,102배로 상승하였습니다측정값
E2 · prefill 과 decode가중치 정밀도를 F32 에서 Q4_K_M 까지 변화시킵니다네 단계 모두에서 decode 의 개선 폭이 prefill 보다 컸습니다측정값
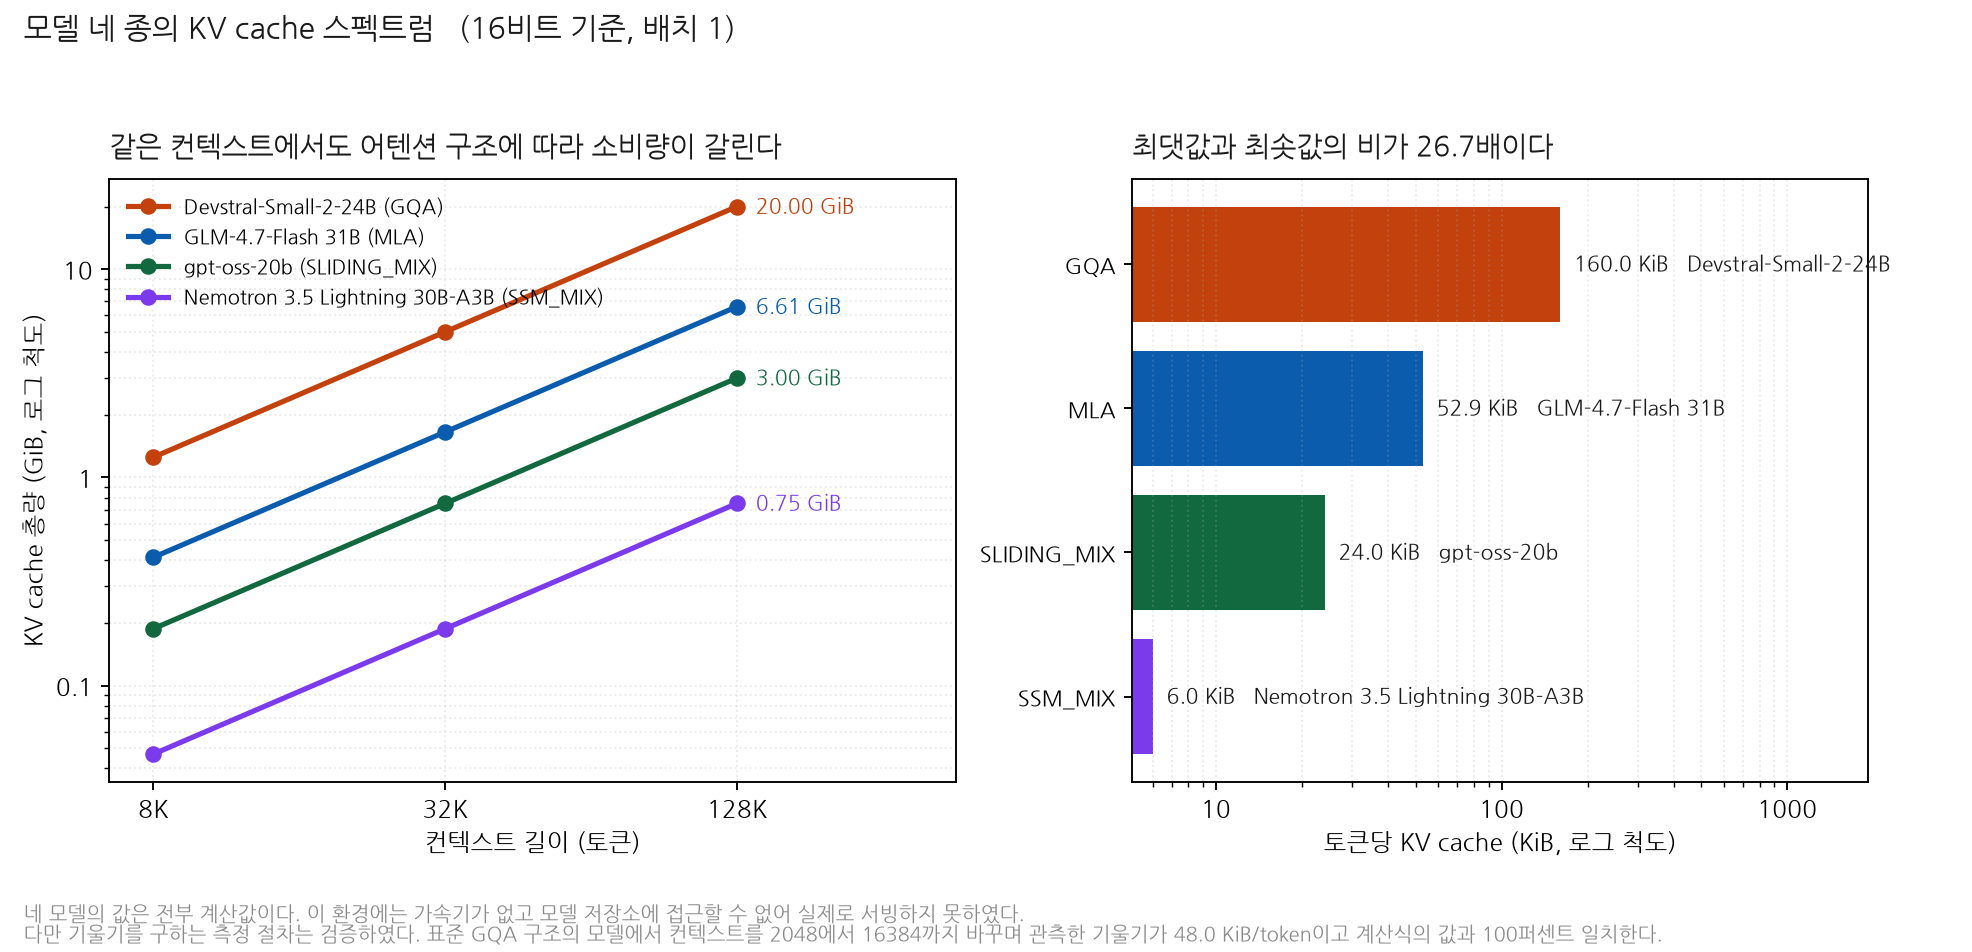
E1 · KV cache 스펙트럼어텐션 구조 네 가지를 비교합니다토큰당 KV cache 가 26.7배 차이가 납니다계산값

실험 결과

E3

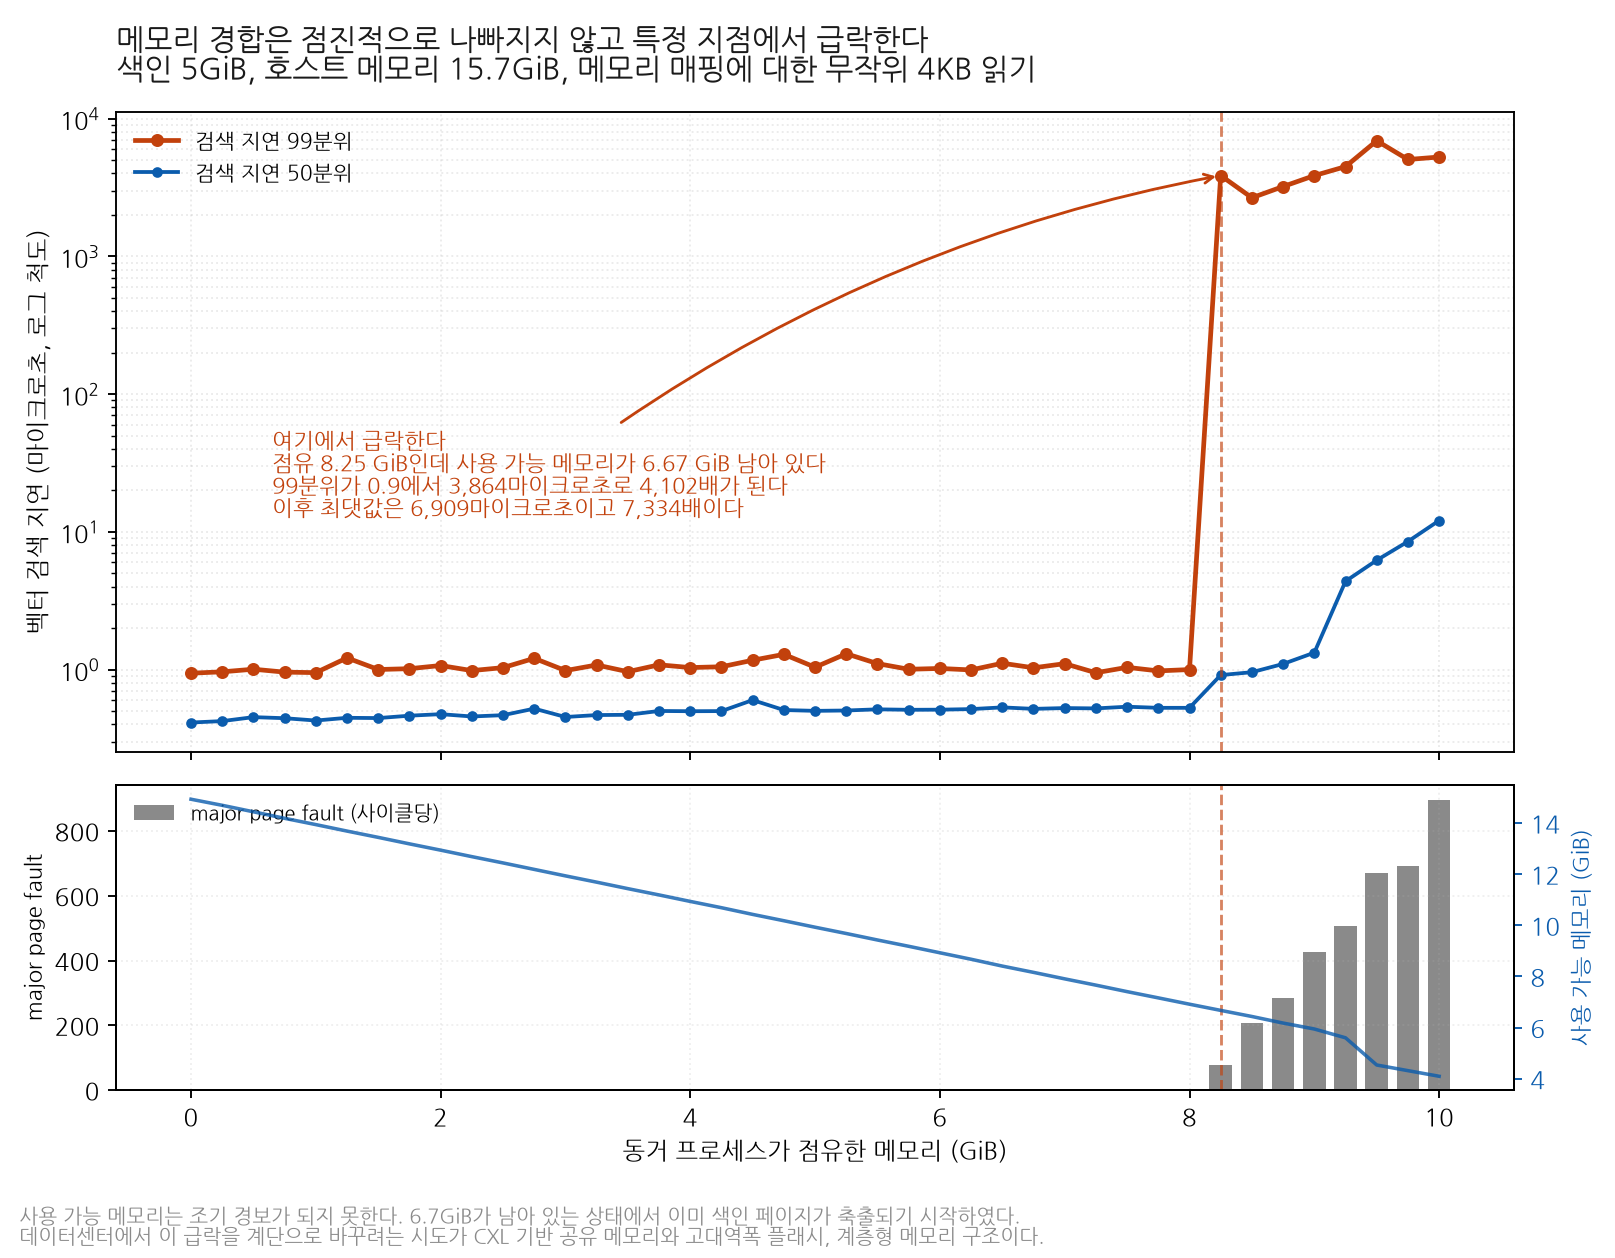
메모리 경합은 점진적으로 나빠지지 않고 특정 지점에서 급락합니다

측정값
점유 메모리를 증가시키며 측정한 벡터 검색 지연입니다. 8.25GB 지점에서 99분위 지연이 급락하고 major page fault 가 함께 증가합니다.
위쪽은 검색 지연의 50분위값과 99분위값이며 로그 척도입니다. 아래쪽은 사이클당 major page fault 와 남아 있는 메모리입니다.

5 GB 벡터 색인을 메모리 매핑으로 열어 두고 무작위 4KB 읽기로 탐색 패턴을 모사합니다. 그 상태에서 동거 프로세스가 메모리를 256 MB 씩 증가시키며 점유하고, 사이클마다 검색 지연과 major page fault 를 기록합니다. 호스트 메모리는 15.7 GB 입니다.

점유량이 8.00 GB 일 때까지 99분위 지연이 1 µs 에서 변하지 않습니다. 8.25 GB 에서 3,864 µs 로 상승하며 이는 기준값의 4,102배입니다. 이 시점에 남아 있는 메모리가 6.67 GB 이고 호스트 메모리의 42퍼센트에 해당합니다.

50분위 지연은 그보다 0.75 GB 뒤에 상승하기 시작합니다. 평균값으로 감시하면 그만큼 늦게 인지하게 됩니다.

색인 2.5 GB 에 호스트 메모리 7.8 GB 인 다른 환경에서도 같은 경향이 관측되었습니다. 그 환경에서는 3.86 GB, 즉 호스트 메모리의 49퍼센트가 남은 지점에서 상승이 시작되었습니다. 절대값은 환경마다 다르지만 경향은 동일합니다.

점유남은 메모리50분위99분위major fault판정
0 GB14.93 GB0.4 µs0.9 µs0기준선입니다
8.00 GB6.92 GB0.5 µs1.0 µs0여기까지는 변화가 없습니다
8.25 GB6.67 GB0.9 µs3,864 µs76급락 지점이며 4,102배입니다
9.00 GB5.94 GB1.3 µs3,860 µs42750분위는 아직 상승하지 않았습니다
9.50 GB4.54 GB6.2 µs6,909 µs669최댓값이며 7,334배입니다
10.00 GB4.10 GB12.1 µs5,266 µs896

이 실험의 한계를 먼저 밝힙니다. 메모리 매핑에 대한 무작위 읽기는 실제 근사 최근접 이웃 탐색의 근사이며, 실제 그래프 탐색은 지역성을 가지므로 저하가 이보다 완만하게 나타납니다. 따라서 이 측정은 급락의 존재와 위치를 보이지만 기울기로는 상한에 해당합니다. 단일 노드에서 수행하였으므로 NUMA 효과와 네트워크 효과는 반영되지 않았습니다.

핵심: 남아 있는 메모리는 조기 경보가 되지 못합니다. 용량 계획을 평균 사용량으로 수립하면 이 급락을 겪게 됩니다. 데이터센터에서 이 급락을 계단 형태로 완화하려는 시도가 CXL 기반 공유 메모리와 고대역폭 플래시와 계층형 메모리입니다.
E2

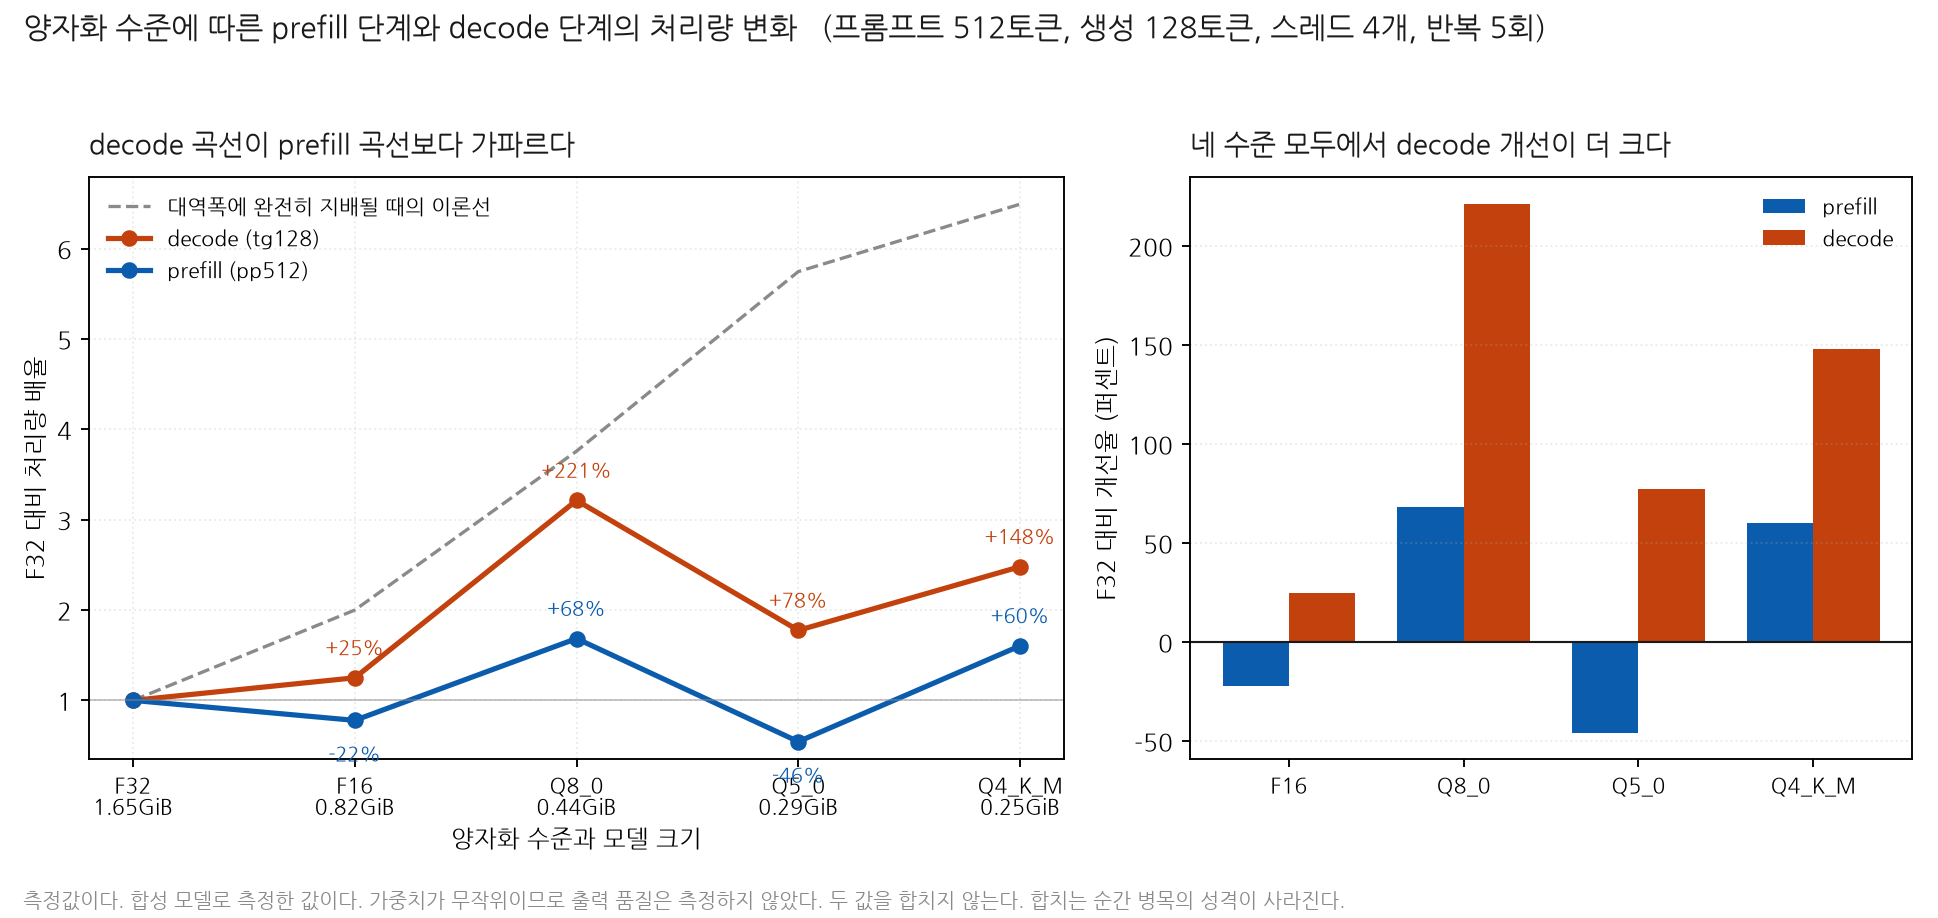
모델을 압축하면 decode 가 prefill 보다 두 배 넘게 개선됩니다

측정값
양자화 수준별 prefill 과 decode 의 처리량입니다. decode 곡선이 prefill 곡선보다 가파릅니다.
왼쪽은 F32 대비 처리량 배율이며 점선은 대역폭에 완전히 지배될 때의 이론선입니다. 오른쪽은 개선율입니다.

같은 모델을 F32 와 F16 과 Q8_0 과 Q5_0 과 Q4_K_M 다섯 수준으로 준비하고 llama-bench 로 처리량을 측정하였습니다. pp512 가 prefill 단계이고 tg128 이 decode 단계입니다. 두 값을 합치지 않았습니다. 합치는 순간 병목의 성격이 사라집니다.

F32 에서 Q4_K_M 으로 낮추면 모델 크기가 0.15배가 되는데 prefill 은 60퍼센트 개선되는 데 그치지만 decode 는 148퍼센트 개선됩니다. 네 단계 전부에서 decode 쪽의 개선 폭이 더 큽니다.

prefill 은 단조롭게 증가하지도 않습니다. F16 과 Q5_0 에서는 오히려 F32 보다 느려집니다. 이 프로세서는 정수 내적 명령을 지원하므로 Q8_0 과 Q4_K_M 은 그 경로를 사용하지만 F16 과 Q5_0 은 사용하지 못하기 때문입니다. prefill 의 성능을 결정하는 것이 모델 크기가 아니라 연산 경로라는 사실은, prefill 이 연산에 의해 제한된다는 진술을 오히려 강하게 뒷받침합니다.

decode 는 대역폭에 완전히 지배될 때의 이론선에도 미치지 못합니다. 모델 크기가 0.15배이므로 이론선은 6.5배이지만 실제 개선은 2.48배에 그칩니다. 역양자화에 연산이 소요되기 때문입니다.

양자화모델 크기prefilldecodeprefill 개선decode 개선
F321.65 GB444.9 tok/s25.9 tok/s기준기준
F160.82 GB346.5 tok/s32.4 tok/s−22.1%+25.0%
Q8_00.44 GB749.5 tok/s83.4 tok/s+68.5%+221.4%
Q5_00.29 GB241.8 tok/s46.0 tok/s−45.7%+77.5%
Q4_K_M0.25 GB713.8 tok/s64.3 tok/s+60.4%+148.0%

모델 가중치를 내려받을 수 없는 환경이므로 같은 구조를 가진 443M 파라미터 모델을 무작위 가중치로 생성하여 측정하였습니다. 처리량은 텐서의 모양과 양자화 형식이 결정하므로 이 측정은 유효합니다. 다만 출력 품질은 측정하지 않았고 측정할 수도 없습니다. 프로세서 4코어에서 측정하였으므로 HBM 대역폭이 아니라 시스템 메모리 대역폭에 대한 값입니다.

핵심: prefill 단계와 decode 단계는 서로 다른 자원을 사용합니다. 두 단계를 하나의 지연으로 합쳐서 보면 어느 쪽에 대응해야 하는지 판별할 수 없게 됩니다.
E1

어텐션 구조에 따라 토큰당 KV cache 가 26.7배 차이가 납니다

계산값
어텐션 구조 네 가지의 토큰당 KV cache 입니다. 최댓값과 최솟값이 26.7배 차이가 납니다.
왼쪽은 컨텍스트 길이별 KV cache 총량이고 오른쪽은 토큰당 KV cache 입니다. 두 축 모두 로그 척도입니다.

어텐션 구조마다 KV cache 의 계산식 자체가 다릅니다. 표준 GQA 는 K 와 V 를 각각 저장하고, MLA 는 저차원 잠재 표현 하나만 저장하므로 계수 2가 없습니다. sliding window 혼합은 full 레이어만 컨텍스트 길이에 비례하고, 상태공간 모형 혼합은 어텐션 레이어만 비례하며 상태는 상수입니다.

네 구조를 같은 조건에 두면 토큰당 160 KiB 에서 6 KiB 까지 차이가 납니다. 컨텍스트 128K 에서 20 GB 를 사용하는 고객과 0.75 GB 를 사용하는 고객이 같은 가속기를 사용합니다. 고객이 어떤 모델을 서빙하는지에 따라 제안할 제품이 달라진다는 뜻입니다.

이 값은 계산값입니다. 가속기가 없어서 네 모델을 실제로 서빙하지 못하였습니다. 다만 기울기를 구하는 측정 절차는 검증하였습니다. 표준 GQA 구조의 모델에서 컨텍스트를 2,048 과 8,192 와 16,384 로 변경하며 엔진이 보고하는 메모리를 관측한 결과, 기울기가 48.0 KiB/token 으로 산출되었고 계산식이 주는 값과 100퍼센트 일치하였습니다.

어텐션 구조토큰당 KV8K32K128K비고
표준 GQA160.0 KiB1.25 GB5.00 GB20.00 GB40층 전부가 컨텍스트 길이에 비례합니다
MLA52.9 KiB0.41 GB1.65 GB6.61 GB잠재 표현 하나만 저장하므로 계수 2가 없습니다
Sliding 혼합24.0 KiB0.19 GB0.75 GB3.00 GBsliding 과 full 이 1대 1이므로 절감은 정확히 절반입니다
상태공간 혼합6.0 KiB0.05 GB0.19 GB0.75 GB52층 가운데 어텐션 6층만 비례합니다

추론 엔진이 구조별 절감을 실제로 적용하는지는 아직 확인하지 못하였습니다. sliding window 가 적용되지 않으면 관측되는 기울기가 계산값의 두 배로 나타납니다. 가속기와 모델을 확보한 다음에 확인할 항목입니다.

핵심: KV cache 가 상수가 되는 모델은 존재하지 않습니다. 기울기가 낮아질 뿐입니다. 따라서 메모리 수요는 사라지지 않고 형태만 변화합니다.

진행 상태

상태
정량 엔진완료모델 5종, 가속기 6종, 계층 7단을 정의하였고 검증 20건을 통과하였습니다
계측 하네스완료페이지 캐시와 major page fault 와 지연 분포를 수집합니다
고객 아키타입완료5종을 작성하였고 출처가 없는 항목이 0건임을 검증 도구로 확인하였습니다
E3 실험측정값두 환경에서 경향이 재현되었습니다
E2 실험측정값합성 모델로 측정하였으며 출력 품질은 측정하지 않았습니다
E1 실험계산값가속기가 없으므로 측정 절차만 검증하였습니다
코드 공개예정정리하는 대로 이 페이지에 올립니다

끝나지 않은 항목은 끝나지 않았다고 기재합니다. 상태가 변하면 이 표를 갱신합니다.

Part 2

AI Engineering

Part 1 의 계산이 어디에서 나왔는지 이해하고 사용하기 위해 먼저 구현한 것들입니다. KV cache 계산식은 ②에서 캐시를 직접 설계하면서 나왔고, 정밀도가 메모리 요구를 어떻게 변화시키는지는 ③에서, 벡터 색인의 메모리는 ④에서 나왔습니다. PyTorch 기본 연산만 사용하였고 nn.Transformer 같은 기성 모듈은 사용하지 않았습니다.

네 프로젝트의 관계: ①은 2017년 원조 Transformer 의 encoder 와 decoder 전체입니다. ②는 그 가운데 decoder 만 사용하는 GPT 계열이며 학습까지 수행합니다. ③은 학습이 끝난 모델을 압축하는 방향이고, ④는 모델 바깥에서 지식을 결합하는 방향입니다.
01

Transformer from scratch (encoder–decoder)

2017년 논문의 구조를 기성 모듈 없이 그대로 코드로 옮겼습니다.

“Attention Is All You Need” 의 encoder 와 decoder 를 PyTorch 기본 텐서 연산만으로 구현하였습니다. scaled dot-product attention 과 multi-head attention 과 encoder 와 decoder 를 연결하는 cross-attention 까지 전부 직접 작성하였습니다. GPT 계열인 ②에는 encoder 도 cross-attention 도 없습니다. 원형 전체를 다룬다는 점이 이 프로젝트의 차이입니다.

동작은 날짜 표기 변환으로 확인하였습니다. 번역의 가장 단순한 형태에 해당합니다. 입력과 출력의 길이와 어순과 표기가 모두 다르기 때문에, encoder 가 입력을 요약하고 decoder 가 cross-attention 으로 그것을 참조하지 않으면 풀리지 않습니다.

구현 범위
  • scaled dot-product attention (√d_k 정규화)
  • multi-head attention: 분할과 병렬 연산과 결합
  • cross-attention: Q 는 decoder 에서, K 와 V 는 encoder 출력에서
  • causal mask 와 padding mask 결합
  • sin/cos positional encoding
  • position-wise FFN 과 잔차 연결과 LayerNorm
  • greedy decoding
코드 주석에 논문의 절 번호를 기재하였습니다.

동작 확인: “1975년 7월 28일” 과 “26 Jul 2003” 과 “01/01/1972” 를 전부 2003-07-26 같은 ISO 형식으로 변환합니다. 학습에 사용하지 않은 테스트 전건을 통과하였습니다.

pip install -r requirements.txt && python train.pyCPU 5~7분이며 외부 다운로드가 없습니다

코드 다운로드 (.zip)
02

GPT from scratch (decoder-only) + KV cache

decoder 만 사용하는 계열의 모델을 직접 작성하고 CPU 에서 학습시켰습니다.

attention 블록부터 학습 루프까지 전부 직접 작성하였습니다. 여기에 KV cache 를 구현하였습니다. 생성할 때 이미 계산한 K 와 V 를 저장해 두고 새 토큰 하나만 계산하는 방식입니다. nanoGPT 계열의 참고 구현에는 없으므로 직접 설계하였습니다.

Part 1 의 계산기가 사용하는 2 × 층 수 × KV head × head dim × 정밀도 계산식이 여기에서 나왔습니다. 이 구현에서 측정한 캐시 크기가 계산식과 일치하는 것을 먼저 확인하고, 같은 식을 대형 모델에 적용합니다.

구현 범위
  • 문자 단위 토큰화와 배치 구성
  • masked self-attention 블록과 pre-LayerNorm 잔차 구조
  • 학습 루프: cross-entropy, AdamW, 학습과 검증 분리
  • 자기회귀 생성
  • KV cache 설계와 구현: 참고 구현에 없는 부분입니다

동작 확인: GPU 없이 학습을 끝까지 수행하였고, 학습된 모델이 코퍼스의 형식을 따라 텍스트를 생성합니다. 학습된 가중치를 함께 넣어 두었으므로 학습 없이 생성만 실행할 수도 있습니다.

pip install -r requirements.txt && python minigpt.pyCPU 약 10분이며 외부 다운로드가 없습니다

코드 다운로드 (.zip)
03

GPT-2 양자화 (FP32 → INT8)

공개 모델을 절반 크기로 압축하고 양자화 단위에 따라 무엇이 달라지는지 비교하였습니다.

GPT-2(124M) 를 동적 양자화로 INT8 로 변환하였습니다. 모델의 내부 구조를 파악해야 하는 작업입니다. GPT-2 는 표준 Linear 대신 Conv1D 를 사용하므로 양자화 API 가 인식하도록 nn.Linear 로 먼저 변환해야 했습니다. 출력층인 lm_head 는 입력 임베딩과 가중치를 공유하고 있으므로 양자화 대상에서 분리하여 FP32 로 유지하였습니다.

그리고 스케일을 행렬 전체에 하나 부여하는 경우와 출력 채널마다 부여하는 경우를 같은 조건에서 비교하였습니다. 비트 수는 동일한데 결과가 달라집니다. Part 1 에서 정밀도를 워크로드의 입력값으로 받는 이유가 여기에 있습니다.

구현 범위
  • Conv1D 를 nn.Linear 로 수학적으로 동일하게 변환
  • 가중치를 공유하는 lm_head 분리
  • per-tensor 와 per-channel 두 구성으로 각각 양자화
  • 동일 조건 평가 루프: 공개 벤치마크 텍스트와 고정 윈도우

동작 확인: 원본과 INT8 두 구성이 같은 조건에서 정상적으로 추론하고 평가됩니다. 크기와 속도와 품질의 변화는 Part 3 에 있습니다.

pip install -r requirements.txt && python quantize_gpt2.py첫 실행은 3~5분이며 GPT-2 를 자동으로 내려받습니다. 이후는 2분입니다

코드 다운로드 (.zip)
04

RAG + Vector DB

답변하기 전에 문서에서 근거를 검색하는 구조를 부품 단위로 조립하였습니다.

문서를 분할하고 임베딩하여 FAISS 색인에 넣고 유사도로 검색한 다음 그 결과를 프롬프트에 삽입하는 과정까지 전부 직접 작성하였습니다. LangChain 같은 프레임워크는 사용하지 않았습니다. 단계마다 무엇이 오가는지 코드에서 확인할 수 있도록 하기 위해서입니다.

색인이 메모리를 얼마나 점유하는지도 여기에서 나왔습니다. Part 1 의 E3 는 이 색인을 키운 다음, 메모리가 부족해지기 시작하면 검색이 어떻게 되는지를 측정합니다.

구현 범위
  • 섹션 단위 분할
  • 임베딩: multilingual-e5, 384차원
  • FAISS IndexFlatIP: 정규화한 다음의 내적이 코사인 유사도와 같습니다
  • top-k 유사도 검색
  • 컨텍스트를 주입한 프롬프트 조립과 실물 저장

동작 확인: 질의 전건에서 정답 문서가 최상위로 검색됩니다. 그렇게 조립된 프롬프트는 results/sample_prompt.txt 에 있습니다. 검색 지연과 색인 메모리는 Part 3 에 있습니다.

pip install -r requirements.txt && python rag_demo.py첫 실행은 2~3분이며 임베딩 모델을 자동으로 내려받습니다. 이후는 30초입니다

코드 다운로드 (.zip)
Part 3

실행 결과

Part 2 의 코드를 실행하여 나온 값들입니다. 인용한 벤치마크가 아니라 직접 구현한 코드에서 나온 값이라는 점이 차이입니다.

측정값

프로젝트항목기준과 해석
01 Transformer파라미터0.18M (175,337)구조를 전부 보이도록 하기 위해 의도적으로 작게 설정하였습니다. 학습은 CPU 로 약 6분이 소요됩니다
변환 정확도500 / 500 (100%)학습에 사용하지 않은 테스트입니다. 형식 변환이므로 정답이 하나로 정해집니다
02 GPT파라미터와 손실0.83M · val 1.88초기값 4.33 은 어휘 65자를 무작위로 선택하는 수준입니다(ln 65 ≈ 4.17). 거기에서 시작하여 감소하였습니다
학습CPU 약 8분 (477초)2000 iteration 이며 GPU 를 사용하지 않았습니다
KV cache 가속×1.79302.9 에서 543.0 tok/s 로 증가하였습니다. 컨텍스트가 128 이라 이 정도이고, 재계산 비용이 O(T²) 이므로 문장이 길수록 차이가 커집니다
KV cache 메모리480.0 KiB= 2(K,V) × 4 layer × 128 dim × 120 토큰 × 4 B. 측정값이 계산식과 일치하였습니다
03 양자화모델 크기−51% (474.8 → 231.8 MB)정확히 절반이 아닌 이유는 FP32 로 유지한 임베딩과 lm_head 가 약 154 MB 이기 때문입니다
생성 속도×1.56 (21.84 → 33.98 tok/s)연산량은 그대로입니다. 읽어야 하는 바이트가 감소하여 빨라졌습니다
품질 손실 (PPL)per-tensor +72% / per-channel +29%비트 수는 동일합니다. 스케일을 얼마나 세밀하게 부여하는지만 다릅니다
04 RAG색인 메모리18.0 KiB= 12 벡터 × 384 차원 × 4 B. 근사와 압축이 없으므로 계산식이 그대로 성립합니다
검색 지연과 정확도0.089 ms · top-1 4/412벡터 규모이므로 지연 자체는 의미를 갖지 않습니다
프롬프트 확장24 ~ 44배21~37자 질의가 915~994자 프롬프트로 확장됩니다

각 프로젝트 zip 의 results/run_log.txt 가 원본이며, 같은 명령을 실행하면 같은 값이 나옵니다. 프로세서만 사용하는 환경인 2 vCPU 에서 측정하였습니다.

해석

A

용량

②의 KV cache 는 대화가 길어질수록, 그리고 동시 사용자가 많아질수록 선형으로 증가합니다. 0.83M 모델에서 480 KiB 였습니다. 같은 계산식을 대형 모델인 96 layer, 12288 dim, FP16 구성에 적용하면 컨텍스트 32k 를 사용하는 사용자 한 명당 약 144 GiB 가 산출됩니다. 그 모델의 가중치가 FP16 으로 약 326 GiB 이므로, 동시 사용자가 서넛만 되어도 캐시가 모델 본체를 초과합니다. 모델을 적재한 다음부터 별도로 누적되는 메모리입니다.

④의 벡터 색인은 층위가 다르지만 방향은 같습니다. Flat 색인의 메모리는 벡터 수 × 차원 × 정밀도 로 정확히 산출됩니다. 이 구현의 18.0 KiB 가 그 계산식과 일치하였고, 근사와 압축이 없으므로 규모를 키워도 그대로 성립합니다. 1억 벡터이면 143 GiB 입니다. 검색 지연 때문에 색인은 저장 장치가 아니라 서버 메모리에 적재되어 있어야 합니다. 가속기에 부착된 HBM 이 아니라 데이터센터 서버의 DRAM 쪽 수요라는 점이 KV cache 와 다릅니다.

핵심: 긴 컨텍스트와 많은 동시 사용자와 검색 증강은 전부 메모리 용량 수요로 이어집니다. AI 서비스가 경쟁하는 축이 그대로 수요가 되며, HBM 과 DRAM 양쪽에서 서로 다른 형태로 나타납니다.
B

대역폭

③에서 INT8 로 변환하고 생성이 1.56배 빨라진 이유는 연산이 감소해서가 아닙니다. 토큰 하나를 생성할 때마다 읽어야 하는 바이트가 절반이 되었기 때문입니다. 언어 모델의 생성 단계는 토큰마다 가중치 전체를 다시 읽습니다. 연산이 아니라 메모리에 의해 제한되는 작업입니다.

여기에 ②의 KV cache 가 더해집니다. 생성 단계는 가중치뿐 아니라 누적된 캐시도 매번 다시 읽습니다. 컨텍스트가 길어지면 읽어야 하는 양이 또 증가합니다. Part 1 의 계산기가 노드당 연산 강도를 임계점과 비교하는 이유가 여기에 있습니다.

핵심: 추론 속도를 결정하는 것은 메모리 대역폭입니다. 얼마나 빨리 계산하는지가 아니라 얼마나 빨리 읽는지의 문제입니다.
C

수요의 형태 변화

양자화는 같은 모델의 메모리 요구를 절반으로 감소시켰습니다. 그런데 산업 전체로 보면 그 절감분은 더 큰 모델과 더 긴 컨텍스트와 더 많은 동시 사용자로 다시 투입되었습니다. 그러는 동안 INT8 과 INT4 같은 저정밀 형식이 확산되면서 저정밀 데이터 경로나 대역폭 구성 같은 새로운 요구가 발생합니다.

같은 실험에서 하나가 더 나왔습니다. 같은 8비트인데 스케일 단위에 따라 품질 손실이 +72퍼센트와 +29퍼센트로 달라집니다. 압축은 켜고 끄는 선택이 아니라 품질과 속도와 메모리를 함께 고려하는 설계입니다. 어떤 정밀도를 어느 단위로 어느 층에 적용하는지가 필요한 메모리의 형태를 변화시킵니다.

핵심: 효율화 기술은 메모리 수요를 감소시키는 요인이 아니라 형태를 변화시키는 요인입니다. 그 변화를 먼저 판별하는 것이 전략의 영역입니다.